

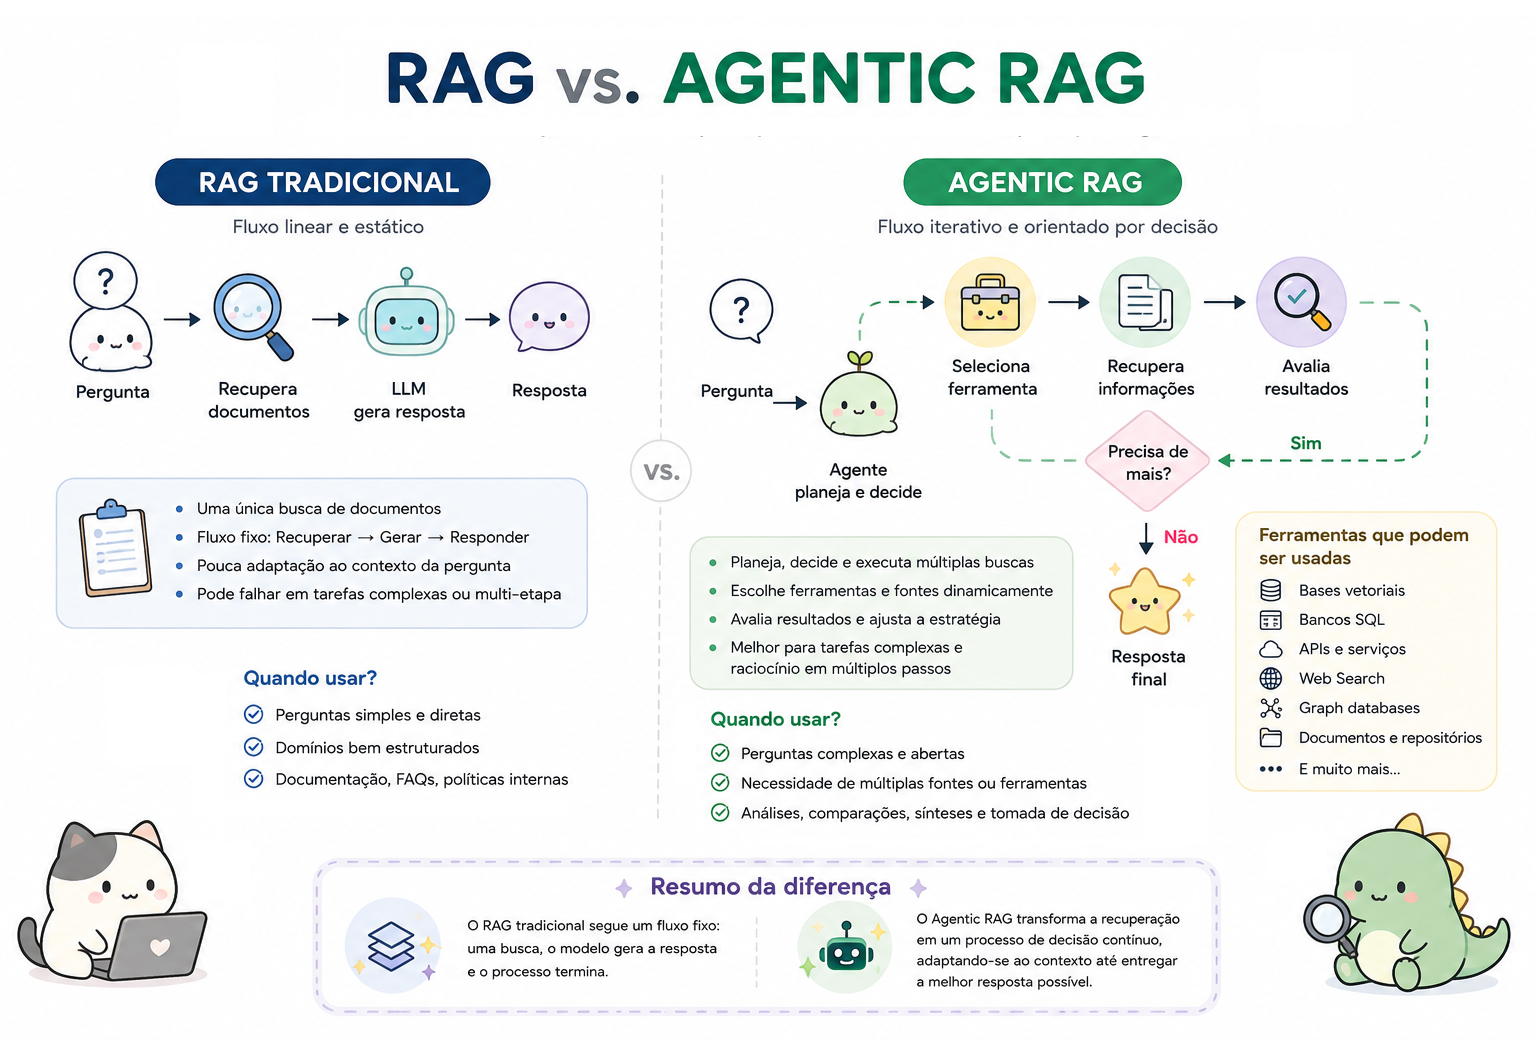
Quando o Retrieval-Augmented Generation (RAG) surgiu, ele resolveu (ou pelo menos tentou resolver) um dos principais problemas dos LLMs (Large Language Models):
A dependência exclusiva do conhecimento armazenado durante o treinamento.
Em vez de responder apenas com base em seus pesos, o modelo passou a consultar documentos externos antes de gerar uma resposta.
Essa mudança tornou os sistemas mais atualizados, mais confiáveis e menos propensos a alucinações.
Mas, conforme os casos de uso ficaram mais complexos, uma nova limitação começou a aparecer.
O problema já não era recuperar informações. Era decidir como, quando e onde recuperá-las.
É justamente nesse contexto que surge o Agentic RAG.
Para mais novidades de IA, me siga no Linkedin e no Instagram ❤
Veja também:
Você não precisa mais abrir 5 abas para criar uma apresentação!
Agent Plugins: o próximo padrão que pode simplificar o desenvolvimento de agentes de IA
Como aprender a usar Machine Learning para Trading e mercado financeiro?
Relembrando o RAG tradicional
Em sua forma mais simples, um sistema RAG segue um pipeline relativamente fixo:
Pergunta
      ↓
Recuperação de documentos
      ↓
LLM
      ↓
Resposta
Independentemente da complexidade da pergunta, o fluxo costuma ser o mesmo:
recuperar documentos;
enviar o contexto para o LLM;
gerar a resposta.
Esse paradigma funciona muito bem para diversos cenários, como:
FAQs;
documentação técnica;
bases de conhecimento corporativas;
manuais;
políticas internas.
Entretanto, ele apresenta limitações quando uma pergunta exige múltiplas etapas de raciocínio ou a combinação de diferentes fontes de informação.
O que muda no Agentic RAG?
A principal diferença é que o LLM deixa de atuar apenas como um gerador de texto e passa a assumir o papel de um agente responsável por tomar decisões durante o processo de recuperação de informações.
Em vez de executar um pipeline rígido, o agente pode decidir:
se realmente precisa consultar uma base de conhecimento;
qual fonte utilizar;
quais ferramentas chamar;
se os documentos recuperados são suficientes;
quando reformular uma consulta;
quando realizar novas buscas;
quando responder.
O fluxo deixa de ser linear e passa a ser iterativo.
Pergunta
      ↓
Planejamento
      ↓
Buscar informações?
      ↓
Selecionar ferramenta
      ↓
Avaliar resultados
      ↓
Nova busca (se necessário)
      ↓
Resposta
Essa autonomia é justamente o que diferencia um pipeline tradicional de um sistema agêntico.
Um exemplo prático
Imagine a seguinte pergunta:
“Compare LangGraph, CrewAI e OpenAI Agents SDK e recomende qual faz mais sentido para um sistema multiagente em produção.”
Um RAG tradicional provavelmente faria uma única recuperação de documentos relevantes e entregaria uma resposta baseada nesse contexto.
Já um Agentic RAG pode executar algo parecido com:
decompor a pergunta em três tecnologias;
recuperar documentação específica de cada framework;
consultar benchmarks ou documentação oficial;
identificar lacunas de informação;
realizar novas buscas;
comparar os resultados;
sintetizar uma recomendação.
Em outras palavras, a recuperação deixa de ser uma única etapa e passa a fazer parte do próprio raciocínio do sistema.
Recuperação deixa de ser passiva
Uma das maiores mudanças conceituais é que recuperar documentos deixa de ser uma operação automática.
O agente pode concluir, por exemplo, que:
a pergunta é simples e não exige recuperação;
uma busca vetorial é suficiente;
é melhor consultar um banco SQL;
vale utilizar uma API externa;
é necessário combinar múltiplas fontes.
Esse tipo de decisão ajuda a reduzir consultas desnecessárias e torna o processo mais eficiente para tarefas complexas.
Muito além do banco vetorial
Embora muitas implementações utilizem um Vector Database, um Agentic RAG pode orquestrar diversas ferramentas durante a execução.
Alguns exemplos incluem:
bancos vetoriais;
bancos relacionais (SQL);
mecanismos de busca como Elasticsearch;
APIs internas;
mecanismos de busca na Web;
Graph Databases;
servidores MCP;
repositórios GitHub;
SharePoint;
Confluence.
Na prática, o agente decide qual ferramenta utilizar em cada etapa do problema.
Planejamento e decomposição
Outra característica importante é a capacidade de transformar um problema complexo em tarefas menores.
Considere a pergunta:
“Quais mudanças ocorreram na LGPD desde a criação da ANPD e quais os impactos para hospitais?”
Em vez de realizar uma única busca, o agente pode dividir o problema em diferentes etapas:
identificar a criação da ANPD;
recuperar alterações regulatórias posteriores;
buscar normas específicas da área da saúde;
sintetizar os impactos para hospitais.
Esse tipo de decomposição é frequentemente chamado de planning, um dos padrões mais importantes em sistemas agênticos.
Os principais padrões agênticos
Grande parte dos trabalhos recentes descreve alguns comportamentos recorrentes em agentes de IA.
Entre os mais conhecidos estão:
Planning
O agente define uma sequência de passos antes de executar a tarefa.
Reflection
Após gerar uma resposta intermediária, o próprio agente a revisa em busca de inconsistências ou lacunas.
Tool Use
O agente escolhe dinamicamente quais ferramentas utilizar durante a execução.
Multi-Agent Collaboration
Diferentes agentes especializados colaboram para resolver partes distintas de um mesmo problema.
Esses padrões podem ser combinados de diversas formas, dependendo da arquitetura adotada.
Frameworks que impulsionam esse ecossistema
O crescimento do Agentic RAG também foi acompanhado pela evolução dos frameworks de desenvolvimento.
Entre os mais utilizados atualmente estão:
LangGraph, para construção de fluxos cíclicos e agentes com estado;
LlamaIndex, com forte suporte à recuperação de documentos e workflows baseados em conhecimento;
CrewAI e AG2, voltados para colaboração entre múltiplos agentes;
plataformas como Amazon Bedrock, Semantic Kernel e Vertex AI, que oferecem infraestrutura para implantação em ambientes corporativos.
Nem todo problema precisa de Agentic RAG
Apesar do entusiasmo em torno do tema, nem toda aplicação se beneficia de uma arquitetura agêntica.
Em muitos casos, um pipeline RAG tradicional continua sendo a melhor escolha por ser mais simples, barato e rápido.
O Agentic RAG tende a fazer mais sentido quando o sistema precisa:
combinar múltiplas fontes de informação;
executar consultas iterativas;
utilizar ferramentas externas;
decompor problemas complexos;
revisar sua própria estratégia de recuperação.
Em outras palavras, trata-se de uma evolução voltada principalmente para tarefas que exigem planejamento e adaptação.
🚀 Gostou desse conteúdo?
Se você quer ir além e ter acesso a materiais exclusivos e a mais de 30 notebooks com exemplos de código, considere tornar-se um assinante pago!
Considerações finais
Agentic RAG representa uma mudança importante na forma como sistemas baseados em LLMs interagem com conhecimento externo.
Em vez de simplesmente recuperar documentos antes de responder, esses sistemas passam a decidir como conduzir todo o processo de recuperação, escolhendo ferramentas, refinando consultas e avaliando continuamente a qualidade das evidências obtidas.
Ainda é uma área em rápida evolução, com novas arquiteturas e propostas surgindo continuamente.
Mas a direção parece clara: a recuperação de informação deixa de ser uma etapa estática do pipeline e passa a integrar o próprio processo de raciocínio do agente.
Para quem projeta aplicações de IA, entender essa mudança será cada vez mais importante, especialmente à medida que sistemas agênticos se tornam parte do desenvolvimento de soluções corporativas.
Excelente distinção, você tocou no ponto nevrálgico: o desafio não é recuperar vetor, é a capacidade de decidir e inferir causalidade. Essa carência de raciocínio causal nos modelos atuais é fascinante. Refleti sobre esse limite de inferência estatística aqui: https://gzambrano.substack.com/p/o-fantasma-de-hume-na-maquina
O texto é bem didático, mas há dois pontos que merecem ser revistos. O primeiro é que se o agente opta por não consultar a base externa, volta a depender do conhecimento paramétrico do LLM. Pular a recuperação reintroduz o problema original e o RAG existe exatamente para evitar esse risco.
O outro detalhe é que o diferencial do Agentic RAG é a iteração: reflection, replanejamento e novas buscas baseadas em lacunas. Orquestrar ferramentas não é agência.